エンドツーエンド vs. ハイブリッド:AI 映像パイプライン
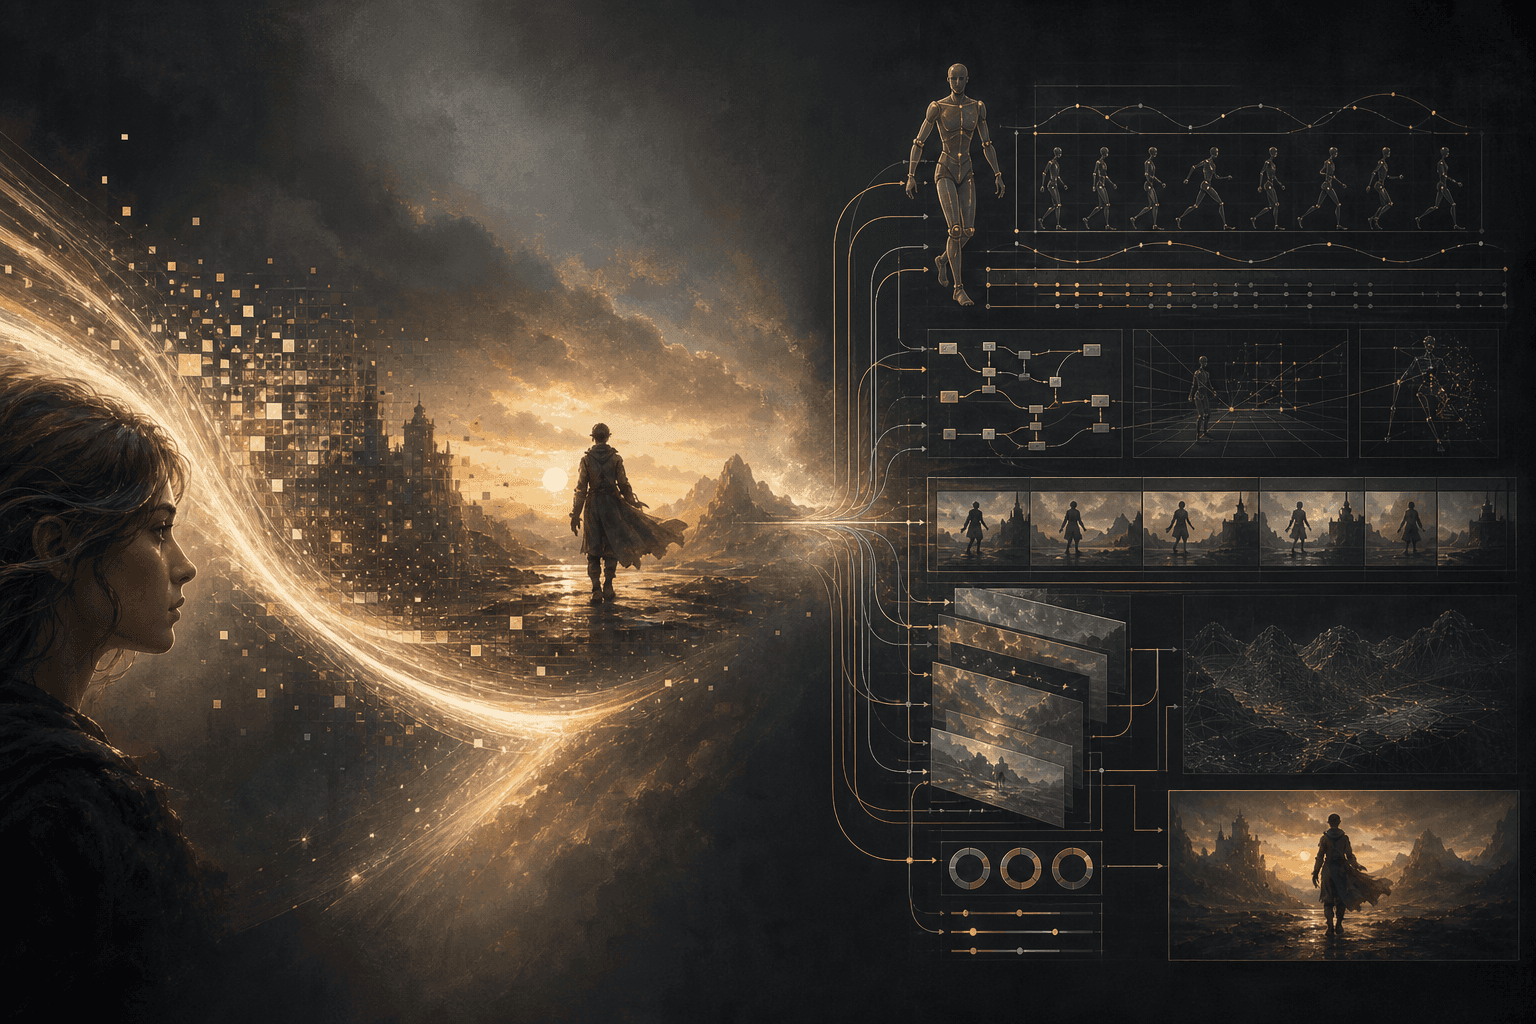
私は AI 映像パイプラインを大きく 2 つに分けて考えています。
ここでの重要な前提は、特に「映像」について話しているということです。
- エンドツーエンドの、ピクセルベースの、AI ネイティブなパイプライン
- AI で強化された従来型パイプライン、つまりハイブリッドパイプライン
これらは単に同じロードマップ上の 2 つの段階ではありません。AI 映像制作パイプラインがどうあるべきかについて、出発点となる信念が異なるのです。
2 つの異なる信念
エンドツーエンドのパイプラインの背後にある思想は、アニメーションや映像の最終的な出力はピクセルである、というものです。必要なピクセルをシステムが直接生み出せるなら、3D モデル、キャラクター、リグ、キーフレーム、そして従来の制作で使われる多くの中間表現は、必ずしも必要ではありません。
それは制作パイプラインを改善しようとはしません。パイプラインがなぜ存在する必要があるのかを問うのです。
ハイブリッドパイプラインは別の信念から始まります。中間の構造こそが重要だ、と。アーティストには、確認し、コントロールし、受け渡し、編集できる表現が必要です。したがって AI は、既存の制作プロセスを迂回するのではなく、そこに参加すべきだと考えます。
この違いは、野心的なアプローチと実用的なアプローチの違いではありません。問題の定義が 2 通りある、ということです。
エンドツーエンドパイプラインの性質
エンドツーエンドの映像生成が強力なのは、まさに中間工程を取り除くからです。そして同じ性質が、現在の限界も決めています。
限界
ターゲットが学習データの分布から外れると、現在のモデルは苦戦します:
- オリジナルのキャラクターや人型でないキャラクター
- スタイライズされたスクワッシュ&ストレッチのような、誇張された非線形のポーズ
- 非常に抽象的、あるいは標準的でない物理的な動作
また、確率的で不安定でもあります。そのため、関係者が厳密な予測可能性や確実な結果を期待する状況——特定のカメラアングル、複雑なライティングの連続性、正確なアニメーションの挙動——にはあまり向いていません。
問題は、そうした結果が不可能だということではありません。生成を始める前に、それを常に約束できるわけではない、ということです。
最適な用途
エンドツーエンドの生成は、モデルの学習データの分布がもともと美的な目標と一致しているときに最も力を発揮します:
- リアル、シネマティック、またはファンタジー系の実写的な美学
- ストップモーション風の表現
- 質感のある、高精細な、あるいはアニメ調のビジュアルスタイル
- ピクセル単位の精度よりも、物語の核が重要なストーリー重視のコンテンツ
- 多少の視覚的なアーティファクトを許容し、素早いイテレーションで解消できるプロジェクト
戦略
アニメーションの品質が弱点になるなら、価値の軸を物語、デザイン、世界観の構築へと移しましょう。
強いアイデアは、不完全な動きにも耐えられます。アニメーション重視、演技主導のスタイルはそうはいきません。たとえば古典的な 2D のドタバタ喜劇は、計算されたタイミング、極端なポーズ、表情豊かな演技に支えられています。それらこそが作品の成功の主な理由であるなら、現在のエンドツーエンドのモデルを、まさに最も弱いところで試していることになります。
ハイブリッドのジレンマの本質
ハイブリッドパイプラインの根本的な課題は、人が編集できるワークフローと AI が生成する出力との間に、共通のデータ構造がないことです。
共通の構造がなければ、アーティストとモデルの協働は限られてしまいます。
Figma やコード生成がうまくいくのは、AI が編集可能な形式を出力するからです。HTML やソースコードを出力でき、人はそこから作業を続けられます。出力はワークフローの一部であり続けます。
現在の画像・映像モデルが出力するのは、むしろバイナリに近い結果、つまり平面的なピクセルです。人はそのピクセルを評価することはできても、それを生み出した判断を直接調整することはできません。
アニメーターにとっては、スケルトンのキーフレームだけでは足りません。役に立つシステムなら、アニメーターが実際に扱うコントローラーとキーフレームを出力する必要があります。そうでなければ、結果はやはり人が編集できる形に変換し直さなければなりません。
人と AI の間に架けられる橋
このギャップに取り組む方法はいくつかあります。
データを変換する
AI が生成したアニメーションを Maya に取り込み、コントロールを組み直し、手作業でクリーンアップしたり、ロトスコープで編集可能な情報を取り戻したりできます。
これは機能しますが、変換自体にコストがかかります。生成結果の価値は、節約できた時間が、変換とクリーンアップにかかる時間を上回るかどうかで決まります。
プロトコルを標準化する
人のツールと AI モデルが、USD のような共通のデータ構造を通じてやり取りすることもできます。
このモデルでは、AI の出力は孤立した結果ではなくなります。アーティストに必要な情報を保ったまま、ツール間を行き来できる構造化された制作データになるのです。
AI を最終ノードとして使う
AI をパイプラインの末尾、つまり人による編集が必要な最後の地点より後ろに置くこともできます。
これなら往復を避けられます。従来のパイプラインが上流でコントロールを提供し、AI は誰もそこから編集可能なデータを取り戻す必要がないときにだけ、最終結果を生成します。モーションの中割りはこの方式で機能します。欠けている動きを生成するコストが、出力をクリーンアップするコストより低ければ効率的です。
私たちが本当に守ろうとしているものは何か?
2 つのパイプラインの思想は共存できますし、どちらも大きく進化しうるでしょう。
エンドツーエンドのモデルは、より強いコントロール、より良い一貫性、珍しいキャラクターや動きについてのより幅広い知識を獲得するかもしれません。ハイブリッドのシステムは、共通のプロトコル、編集可能なコントローラーデータ、そして AI の出力と従来ツールの間のずっと安価な変換を手に入れるかもしれません。
しかし、あらゆる技術的な問題を解決しても、2 つのアプローチが等価になるわけではありません。
最終目標が単にピクセルを得ることなら、あらゆる中間表現は、なぜ存在するのかを正当化し続けなければなりません。完璧な交換フォーマット、編集可能なリグ、AI と Maya の間のロスのない橋は、協働の問題を完全に解決するかもしれません。それでも、そのどれもが最初の前提を変えることはありません。
目標にピクセル以外のもの——再利用可能なアセット、シミュレーションデータ、インタラクティブな世界、あるいは最終フレームとは独立して価値を持つコントロール——が含まれるなら、そうした構造には独自の目的があります。
本当の問いは、今日どちらのパイプラインがうまく機能するか、ではありません。
意図とピクセルの間に、まだ何かが存在する必要があるのかどうか、です。