端到端 vs. 混合式 AI 影像 Pipeline
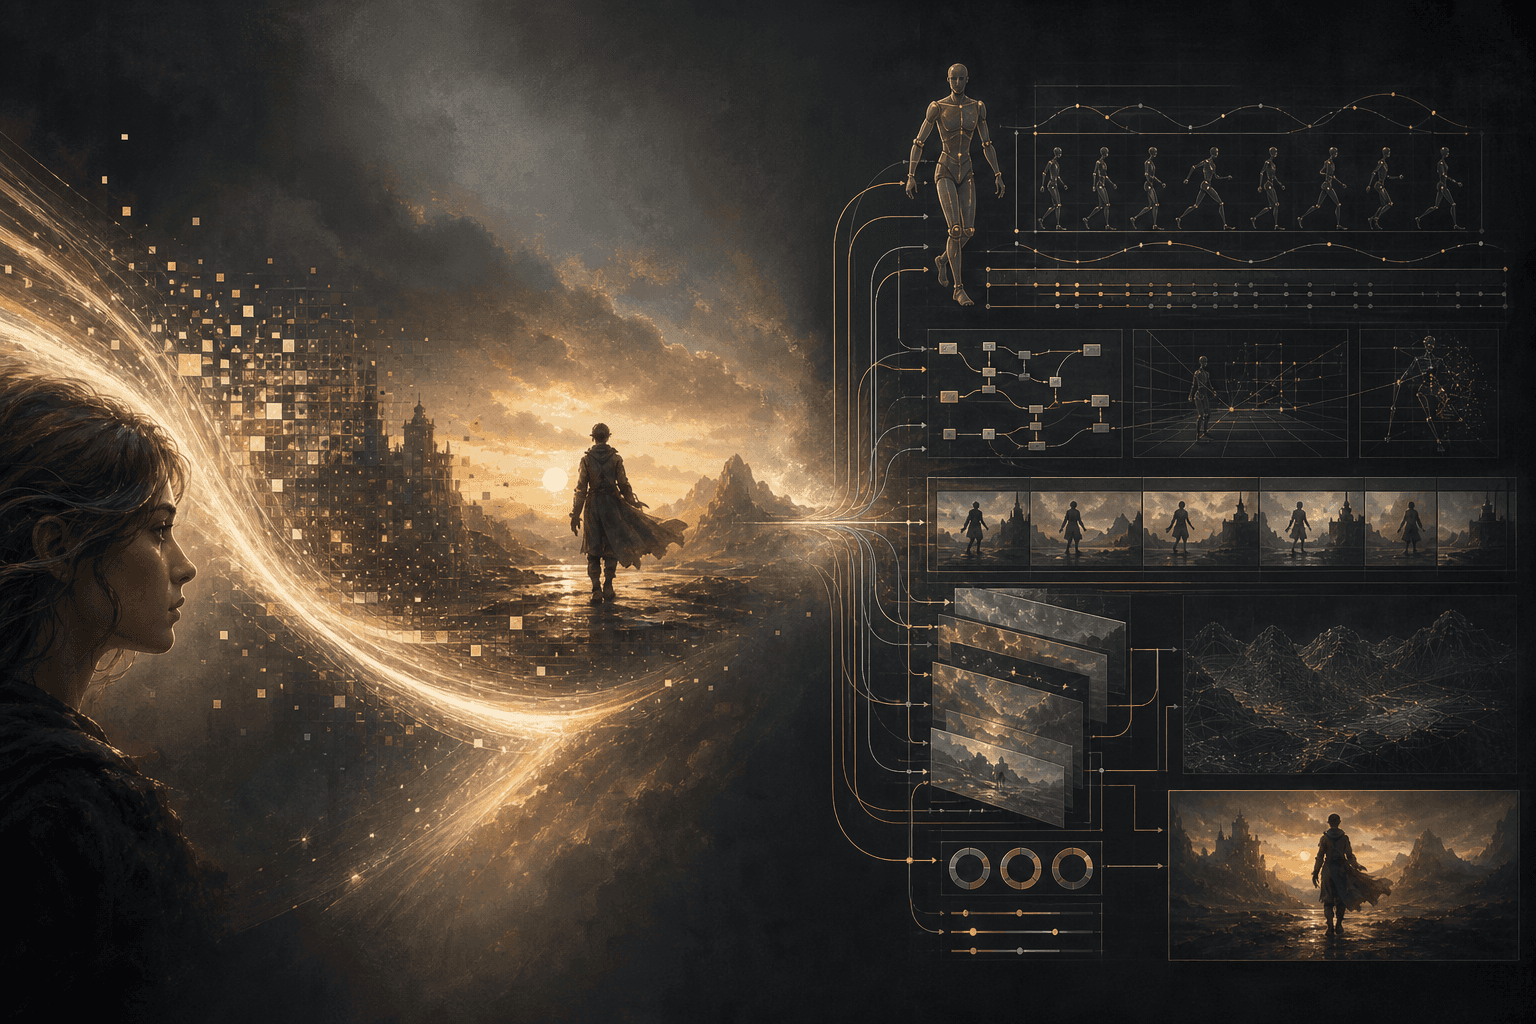
我把 AI 影像 pipeline 分成兩大類。
這裡的關鍵前提是:我們討論的特別是影像。
- 端到端、以像素為基礎、AI 原生的 pipeline
- AI 強化的傳統 pipeline,或稱混合式 pipeline
這兩者並不只是同一條路線圖上的兩個階段。它們從一開始就對「AI 影像製作 pipeline 應該是什麼」抱持不同的信念。
兩種不同的信念
端到端 pipeline 背後的理念是:動畫與影像的最終產出是像素。如果一個系統能直接產生我們需要的像素,那我們就不一定需要 3D 模型、角色、綁定、關鍵影格,或傳統製作中使用的許多中間表示。
它不試圖改善製作 pipeline。它質疑的是 pipeline 為什麼需要存在。
混合式 pipeline 則從不同的信念出發:中間結構很重要。藝術家需要能檢視、控制、交換與編輯的表示形式。因此,AI 應該參與既有的製作流程,而不是繞過它。
這個區別不在於一個有野心、一個務實,而在於對問題的兩種定義。
端到端 Pipeline 的本質
端到端影像生成之所以強大,正是因為它移除了中間步驟。而同樣的特性也界定了它目前的限制。
限制
當目標落在訓練分布之外時,目前的模型就會很吃力:
- 自訂或非人形的角色
- 誇張、非線性的姿勢,例如風格化的擠壓與拉伸
- 高度抽象或非典型的物理動作
它們也是隨機且不穩定的。這讓它們不適合用在利害關係人期待嚴格可預測性或保證結果的情境:特定的攝影機角度、複雜的光線連續性,或精確的動畫行為。
問題不在於這些結果做不到,而在於無法在生成開始前就總是保證做得到。
最佳使用情境
當模型的訓練分布本來就與美學目標一致時,端到端生成的表現最好:
- 寫實、電影感或奇幻風格的真人實拍美學
- 模擬定格動畫
- 有質感、高擬真或受動漫啟發的視覺風格
- 以故事為主的內容,核心敘事比像素級的精準更重要
- 能容忍些微視覺瑕疵、並透過快速迭代解決它們的專案
策略
當動畫品質成為弱點時,就把價值主張轉向敘事、設計與世界觀建構。
強大的點子能撐過不完美的動作。以動畫與表演為核心的風格則沒那麼寬容。例如經典的 2D 鬧劇,仰賴刻意的節奏、極端的姿勢與富表現力的表演。如果這些正是作品成功的主要原因,那就等於正好在目前端到端模型最弱的地方考驗它們。
混合式困境的本質
混合式 pipeline 的根本挑戰,在於人類可編輯的工作流程與 AI 生成的輸出之間,缺乏共用的資料結構。
少了這個共用結構,藝術家與模型之間的協作就很有限。
Figma 與程式碼生成之所以可行,是因為 AI 產出的是可編輯的格式。它可以輸出 HTML 或原始碼,人類可以從那裡接手。輸出仍然是工作流程的一部分。
目前的圖像與影像模型產出的,更接近二元的結果:平面的像素。人類可以評估這些像素,卻無法直接調整產生它們的那些決策。
對動畫師來說,骨架的關鍵影格還不夠。一個有用的系統需要輸出動畫師實際使用的控制器與關鍵影格。否則,結果仍然得被轉換回人類可編輯的形式。
人類與 AI 之間可能的橋樑
有幾種方式可以處理這個落差。
轉換資料
我們可以把 AI 生成的動畫轉進 Maya、重建控制器、手動清理,或用轉描(rotoscoping)找回可編輯的資訊。
這可行,但轉換本身有成本。生成結果的價值,取決於省下的時間是否大於轉換與清理所花的時間。
標準化協定
人類的工具與 AI 模型可以透過像 USD 這樣的共用資料結構溝通。
在這個模式下,AI 的輸出不再是孤立的結果,而是結構化的製作資料,能在工具之間流動,同時保留藝術家需要的資訊。
把 AI 當作最終節點
AI 也可以位於 pipeline 的尾端,在最後一個需要人工編輯的環節之後。
這避免了來回轉換。傳統 pipeline 在上游提供控制,而 AI 只在沒有人需要從中找回可編輯資料時,才產出最終結果。動作中間影格的補間(in-betweening)就可以這樣運作:當生成缺少的動作比清理輸出更省成本時,它就很有效率。
我們真正想保留的是什麼?
這兩種 pipeline 理念可以共存,而且兩者都可能變得強大許多。
端到端模型可能會獲得更強的控制、更好的一致性,以及對特殊角色與動作更廣的知識。混合式系統可能會發展出共用協定、可編輯的控制器資料,以及在 AI 輸出與傳統工具之間便宜得多的轉換。
但解決所有技術問題,並不會讓這兩種做法變得等價。
如果最終目標只是得到像素,那麼每一個中間表示都必須持續證明自己存在的理由。完美的交換格式、可編輯的綁定,或 AI 與 Maya 之間無損的橋樑,也許能完全解決協作的問題。但它們都不會改變最初的前提。
如果目標包含像素以外的東西——可重複使用的素材、模擬資料、互動式世界,或是獨立於最終畫面之外仍有價值的控制——那麼這些結構就有它們自己的目的。
真正的問題不是今天哪一種 pipeline 比較好用。
而是在意圖與像素之間,是否還有任何東西需要存在。